
تفسير نتائج التحليل الإحصائي هو تحويل الأرقام التي يُخرجها برنامج مثل SPSS (المتوسطات، وقيمة الاختبار، ومستوى الدلالة Sig.) إلى إجابة واضحة عن سؤال الدراسة: هل يوجد فرق أو علاقة أو تأثير؟ وما اتجاهه وحجمه؟ وماذا يعني ذلك في ضوء الإطار النظري والدراسات السابقة؟
كثير من طلاب الماجستير والدكتوراه ينفّذون التحليل بشكل صحيح، ثم يتوقفون أمام الجداول: أي صف أقرأ؟ وما معنى Sig. = 0.000؟ وكيف أكتب النتيجة في فصل النتائج؟ في هذا الدليل نشرح الأساسيات التي تحتاجها قبل التفسير، ثم خطوات التفسير، ثم مثالًا عمليًا يبدأ من جدول SPSS وينتهي بفقرة جاهزة للرسالة، مع أشهر الأخطاء التي يقع فيها الباحثون.
إذا كنت لم تجرِ التحليل بعد، ابدأ بمقال ما هو التحليل الإحصائي؟ أنواعه وخطواته، وإذا كنت تفضّل أن يتولى محلل متخصص التحليل وكتابة التفسير بلغة رسالتك، فهذا ما تقدمه خدمة التحليل الإحصائي المتكاملة.
أساسيات تفسير النتائج: الفرضيات ومستوى الدلالة وقيمة p
قبل الغوص في جداول المخرجات المعقدة، يجب على الباحث أن يرسخ فهمه لثلاثة مفاهيم إحصائية محورية تشكل حجر الزاوية في عملية التفسير.
1. الفرضيات الإحصائية: الصفرية والبديلة
كل تحليل إحصائي استدلالي يبدأ بوضع فرضيتين متنافيتين:
•الفرضية الصفرية (Null Hypothesis – H0): تفترض عدم وجود علاقة، أو عدم وجود فرق، أو عدم وجود تأثير بين المتغيرات. هي نقطة البداية التي يحاول الباحث دحضها.
•الفرضية البديلة (Alternative Hypothesis – Ha): تفترض وجود علاقة، أو فرق، أو تأثير. وهي الفرضية التي يسعى الباحث لإثباتها.
مهمة المفسر: التحليل الإحصائي لا “يثبت” الفرضية البديلة، بل يحدد ما إذا كانت هناك أدلة كافية لرفض الفرضية الصفرية.
2. مستوى الدلالة (Significance Level – α)
يُعرف مستوى الدلالة، أو مستوى الخطأ المسموح به، بـ ألفا (α). وهو يمثل الاحتمالية القصوى لرفض الفرضية الصفرية وهي صحيحة (الخطأ من النوع الأول).
•القيمة الشائعة: في معظم الأبحاث الاجتماعية والتربوية، يتم تحديد α عند 0.05 (أي 5%).
•المعنى: إذا كانت قيمة α = 0.05، فهذا يعني أن الباحث مستعد لقبول نسبة خطأ 5% في قراره برفض الفرضية الصفرية.
3. القيمة الاحتمالية (P-value)
هي النجم في مخرجات التحليل الإحصائي. الـ P-value هي الاحتمالية التي نحصل عليها من التحليل، وتمثل احتمال الحصول على النتائج المرصودة (أو نتائج أكثر تطرفًا) إذا كانت الفرضية الصفرية صحيحة بالفعل.
قاعدة القرار الإحصائي:
| الحالة | القرار الإحصائي | التفسير العملي |
| P-value < α (0.05) | نرفض الفرضية الصفرية | توجد دلالة إحصائية. يوجد فرق/علاقة/تأثير. |
| P-value ≥ α (0.05) | لا نرفض الفرضية الصفرية | لا توجد دلالة إحصائية. لا توجد أدلة كافية على وجود فرق/علاقة/تأثير (وهذا لا يثبت أنه غير موجود). |
مثال تطبيقي: إذا كانت قيمة P-value لاختبار “ت” هي 0.001، وهي أقل من 0.05، فإننا نرفض الفرضية الصفرية ونستنتج أن هناك فرقًا ذا دلالة إحصائية بين المجموعتين.
جرّب المعمل الإحصائي المجاني
احسب ثبات استبيانك (ألفا كرونباخ)، وحلّل العبارات، واستخرج الإحصاء الوصفي والتكرارات، مع تفسير بالعربي والإنجليزي.
خطوات تفسير نتائج التحليل الإحصائي
تفسير النتائج هو عملية منهجية تتطلب الدقة والربط بين الأرقام والنظرية.
الخطوة 1: فهم مخرجات البرنامج الإحصائي
قبل البدء في التفسير، يجب أن تكون ملمًا بكيفية قراءة الجداول الإحصائية التي يولدها البرنامج.
•الجداول الوصفية (Descriptive Tables): تحتوي على المتوسطات، الانحرافات المعيارية، التكرارات، والنسب المئوية.
•جداول الاختبارات (Test Tables): تحتوي على قيمة الاختبار (مثل t أو F)، درجات الحرية (df)، وقيمة الدلالة (Sig. أو P-value).
الخطوة 2: تفسير الإحصاء الوصفي (Descriptive Statistics)
الإحصاء الوصفي هو أول ما يجب تفسيره، فهو يرسم صورة واضحة للبيانات قبل الانتقال إلى الاستدلال.
1.المتوسطات (Means): تشير إلى القيمة المركزية للمتغير. تفسيرها يكون بوصف مستوى الظاهرة (مرتفع، متوسط، منخفض) بناءً على مقياس ليكرت المستخدم.
2.الانحراف المعياري (Standard Deviation): يشير إلى مدى تشتت البيانات حول المتوسط. كلما كان الانحراف المعياري أصغر، كانت البيانات أكثر تجانسًا، والعكس صحيح.
3.التكرارات والنسب المئوية (Frequencies and Percentages): تُستخدم لوصف المتغيرات الفئوية (مثل الجنس، المستوى التعليمي). تفسيرها يكون بتحديد الفئة الأكثر تكرارًا والأقل تكرارًا.
الخطوة 3: تفسير الإحصاء الاستدلالي (Inferential Statistics)
هنا يتم اختبار الفرضيات واتخاذ القرار الإحصائي بناءً على الـ P-value.
1.قيمة الاختبار (Test Statistic): مثل قيمة t في اختبار “ت”، أو قيمة F في تحليل التباين. هذه القيمة هي أساس الحكم الإحصائي.
2.درجات الحرية (Degrees of Freedom – df): قيمة مهمة لتحديد توزيع الاحتمالات، وتعتمد على حجم العينة وعدد المجموعات.
3.قيمة الدلالة (P-value): كما ذكرنا سابقًا، هي مفتاح القرار. وإذا ظهرت Sig. = 0.000 في SPSS فلا تكتب p = 0، بل اكتب p < 0.001.
الخطوة 4: ربط النتائج بالإطار النظري
هذه هي الخطوة الأهم. يجب على الباحث أن يربط النتائج الإحصائية بـ الإطار النظري للدراسة والدراسات السابقة.
•المقارنة: هل تتفق النتائج مع ما توصلت إليه الدراسات السابقة؟
•التفسير: إذا كانت النتائج مختلفة، ما هي الأسباب المحتملة؟ (اختلاف العينة، السياق الثقافي، الأدوات المستخدمة).
•التوصيات: بناءً على التفسير، ما هي التوصيات العملية والعلمية التي يمكن تقديمها؟
مثال عملي: من جدول SPSS إلى فقرة في الرسالة
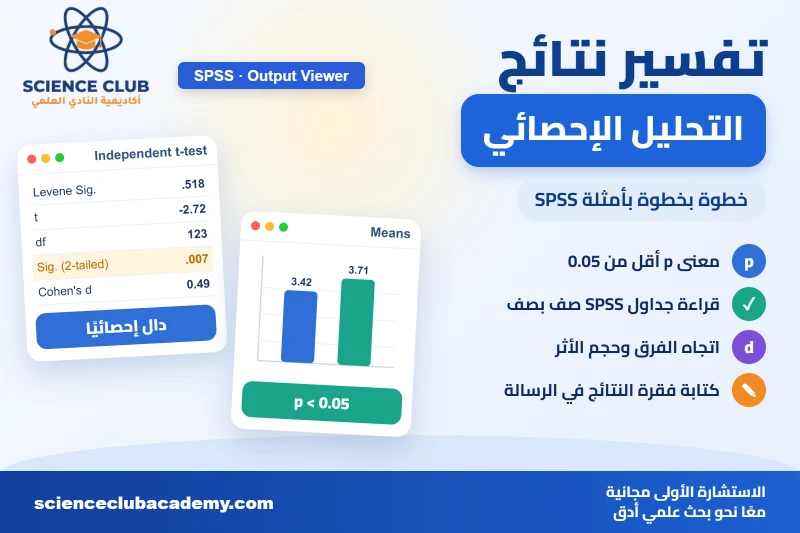
ملاحظة: البيانات التالية توضيحية لشرح طريقة القراءة فقط، وليست من دراسة حقيقية. باحث يقارن مستوى الرضا الوظيفي (مقياس ليكرت من 1 إلى 5) بين المعلمين والمعلمات، واستخدم اختبار “ت” لعينتين مستقلتين.
1. جدول الإحصاءات الوصفية (Group Statistics)
| المجموعة | N | Mean | Std. Deviation |
| ذكور | 60 | 3.42 | 0.61 |
| إناث | 65 | 3.71 | 0.58 |
2. جدول الاختبار (Independent Samples Test)
| الصف | Levene F | Levene Sig. | t | df | Sig. (2-tailed) | Mean Difference |
| Equal variances assumed | 0.42 | 0.518 | -2.72 | 123 | 0.007 | -0.29 |
3. كيف نقرأ الجدول؟
- اختبار ليفين أولًا: Sig. = 0.518 أكبر من 0.05، فالتباين متجانس، ونقرأ صف Equal variances assumed.
- قيمة الدلالة: Sig. (2-tailed) = 0.007 أقل من 0.05، فنرفض الفرضية الصفرية: يوجد فرق دال إحصائيًا.
- اتجاه الفرق: نرجع لجدول المتوسطات: متوسط الإناث (3.71) أعلى من الذكور (3.42)، فالفرق لصالح الإناث. الإشارة السالبة في t معناها فقط أن المجموعة الأولى أقل.
- حجم الأثر: d لكوهين = 0.49 تقريبًا، أي أثر متوسط حسب معايير كوهين.
4. كيف تكتب النتيجة في الرسالة؟
أظهرت نتائج اختبار “ت” لعينتين مستقلتين وجود فرق ذي دلالة إحصائية عند مستوى (0.05) بين متوسطي الرضا الوظيفي لدى المعلمين والمعلمات، حيث بلغت قيمة ت(123) = -2.72، بمستوى دلالة (0.007)، وكان الفرق لصالح المعلمات (م = 3.71، ع = 0.58) مقارنة بالمعلمين (م = 3.42، ع = 0.61)، بحجم أثر متوسط (d = 0.49).
بعد هذه الفقرة يأتي دور المناقشة: هل تتفق النتيجة مع الدراسات السابقة؟ وما التفسير المحتمل لارتفاع الرضا لدى المعلمات في سياق دراستك؟
5. مثال سريع على الارتباط
إذا أظهر جدول Correlations في SPSS أن Pearson Correlation = 0.46 وSig. (2-tailed) = 0.000 لعينة من 150 فردًا، تُكتب النتيجة هكذا:
توجد علاقة ارتباطية طردية متوسطة ذات دلالة إحصائية بين الرضا الوظيفي والأداء المهني (r = 0.46، p < 0.001، n = 150).
لاحظ أننا كتبنا p < 0.001 وليس p = 0.000.
6. وماذا لو كانت النتيجة غير دالة؟
لو أظهر تحليل التباين الأحادي أن F(2, 147) = 1.84 وSig. = 0.162:
لا توجد فروق ذات دلالة إحصائية عند مستوى (0.05) في الرضا الوظيفي تُعزى لمتغير سنوات الخبرة، F(2, 147) = 1.84، p = 0.162.
وهنا لا نحتاج اختبارات ما بعد المقارنة (Post-hoc)، لأن النتيجة العامة غير دالة.
تفسير نتائج الاختبارات الشائعة في SPSS: ت وANOVA والارتباط والانحدار
لتحقيق التميز البحثي، يجب على الباحث أن يفهم بعمق كيفية تفسير أشهر الاختبارات الإحصائية.
1. تفسير اختبار “ت” (T-Test)
يُستخدم اختبار “ت” لمقارنة متوسطين. هناك ثلاثة أنواع رئيسية:
| نوع اختبار “ت” | الغرض | الفرضية الصفرية (H0) |
| عينة واحدة | مقارنة متوسط العينة بمتوسط مجتمع معروف. | لا يوجد فرق بين متوسط العينة ومتوسط المجتمع. |
| عينتان مستقلتان | مقارنة متوسطي مجموعتين مختلفتين (مثل الذكور والإناث). | لا يوجد فرق بين متوسطي المجموعتين. |
| عينتان مرتبطتان | مقارنة متوسطي نفس المجموعة قبل وبعد تطبيق برنامج ما. | لا يوجد فرق بين القياس القبلي والبعدي. |
كيفية التفسير:
1.قراءة اختبار ليفين (Levene’s Test): في حالة اختبار “ت” لعينتين مستقلتين، يجب أولاً قراءة اختبار ليفين لتحديد ما إذا كان التباين متساويًا بين المجموعتين (Sig. > 0.05) أو غير متساوي (Sig. < 0.05). هذا يحدد الصف الذي ستعتمد عليه في قراءة قيمة t وقيمة Sig.
2.قراءة قيمة Sig. (P-value):
•إذا كانت Sig. < 0.05، نرفض H0 ونستنتج وجود فرق ذي دلالة إحصائية.
•إذا كانت Sig. ≥ 0.05، لا نرفض H0 ونستنتج عدم وجود فرق ذي دلالة إحصائية.
3.تحديد اتجاه الفرق: إذا وُجد فرق ذو دلالة، يجب العودة إلى جدول المتوسطات (Means) لتحديد أي المجموعتين لديها متوسط أعلى.
للتفاصيل الكاملة عن أنواع الاختبار وشروطه راجع مقال اختبار T في SPSS: الأنواع والشروط وطريقة تفسير النتائج.
2. تفسير تحليل التباين الأحادي (One-Way ANOVA)
يُستخدم تحليل التباين الأحادي لمقارنة متوسطات ثلاث مجموعات أو أكثر (مثل مقارنة أداء الطلاب في ثلاث جامعات مختلفة).
كيفية التفسير:
1.قراءة جدول ANOVA (Source Table):
•قيمة F: هي قيمة الاختبار.
•قيمة Sig. (P-value): هي مفتاح القرار.
2.القرار الإحصائي:
•إذا كانت Sig. < 0.05، نرفض H0 ونستنتج أن هناك فرقًا ذا دلالة إحصائية بين متوسطات المجموعات ككل.
3.اختبارات ما بعد المقارنة (Post-hoc Tests): إذا كانت نتيجة ANOVA دالة إحصائيًا، فهذا يعني أن هناك فرقًا في مكان ما، لكنه لا يحدد بين أي المجموعات تحديدًا. هنا نستخدم اختبارات ما بعد المقارنة (مثل Tukey أو Scheffé) لتحديد أزواج المجموعات التي تختلف متوسطاتها عن بعضها البعض.
3. تفسير الارتباط (Correlation)
يُستخدم الارتباط لقياس قوة واتجاه العلاقة بين متغيرين كميين. أشهر معامل هو معامل ارتباط بيرسون (Pearson’s r).
كيفية التفسير:
1.قيمة المعامل (r): تتراوح بين -1 و +1.
•القرب من +1: علاقة طردية قوية (كلما زاد متغير، زاد الآخر).
•القرب من -1: علاقة عكسية قوية (كلما زاد متغير، نقص الآخر).
•القرب من 0: علاقة ضعيفة أو منعدمة.
2.قيمة Sig. (P-value): تحدد ما إذا كانت العلاقة المكتشفة ذات دلالة إحصائية.
•إذا كانت Sig. < 0.05، فالعلاقة دالة إحصائيًا، أي أن احتمال ظهورها بالصدفة وحدها ضعيف. والارتباط لا يعني أن أحد المتغيرين سبب في الآخر.
ولمعرفة متى تستخدم بيرسون ومتى تستخدم سبيرمان، راجع مقال معامل الارتباط بيرسون وسبيرمان في SPSS.
4. تفسير الانحدار الخطي البسيط والمتعدد (Regression)
يُستخدم الانحدار للتنبؤ بقيمة متغير تابع بناءً على قيمة متغير مستقل واحد (بسيط) أو أكثر (متعدد).
المفاهيم الأساسية في الانحدار:
•معامل التحديد (R-squared): يمثل النسبة المئوية للتغير في المتغير التابع التي يفسرها المتغير (أو المتغيرات) المستقل. كلما اقتربت قيمته من 1، كان النموذج التنبؤي أفضل. مثال: R² = 0.32 يعني أن المتغيرات المستقلة تفسر 32% من التباين في المتغير التابع.
•معاملات الانحدار: المعامل غير المعياري (B) يشير إلى مقدار التغير في المتغير التابع لكل وحدة تغير في المتغير المستقل، أما المعامل المعياري (Beta) فيُستخدم لمقارنة الأهمية النسبية للمتغيرات المستقلة في التنبؤ.
•قيمة Sig. لكل معامل: تحدد ما إذا كان تأثير المتغير المستقل على التابع ذا دلالة إحصائية.
أخطاء شائعة في تفسير النتائج وكيف تتجنبها
عملية التفسير ليست خالية من التحديات، والباحث المحترف هو من يدرك هذه التحديات ويتعامل معها بوعي.
1. تحدي الدلالة الإحصائية مقابل الدلالة العملية
قد تكون النتيجة “دالة إحصائيًا” (P-value < 0.05)، لكنها قد لا تكون ذات أهمية أو دلالة عملية في الواقع.
•مثال: قد تجد فرقًا ذا دلالة إحصائية في متوسط درجات مجموعتين، لكن الفرق الفعلي في المتوسطات لا يتجاوز نقطة واحدة، وهو فرق لا يُحدث تغييرًا حقيقيًا في الممارسة التربوية.
•الحل: استخدام مقاييس حجم التأثير (Effect Size) مثل كوهين دي (Cohen’s d) أو إيتا تربيع (Eta-squared). هذه المقاييس تحدد قوة العلاقة أو حجم الفرق، بغض النظر عن حجم العينة.
2. أخطاء التفسير الشائعة (الخطأ من النوع الأول والثاني)
| نوع الخطأ | التعريف | متى يحدث؟ |
| الخطأ من النوع الأول (Type I Error) | رفض الفرضية الصفرية وهي صحيحة. | عندما تكون P-value < 0.05، لكن الفرق المكتشف كان صدفة. |
| الخطأ من النوع الثاني (Type II Error) | عدم رفض الفرضية الصفرية وهي خاطئة. | عندما تكون P-value ≥ 0.05، لكن هناك فرقًا حقيقيًا لم يتم اكتشافه (غالبًا بسبب صغر حجم العينة). |
التعامل مع الأخطاء: يجب على الباحث أن يوازن بين هذين النوعين من الأخطاء. تقليل α (مثل استخدام 0.01 بدلاً من 0.05) يقلل من الخطأ من النوع الأول ولكنه يزيد من الخطأ من النوع الثاني.
3. مشكلة الافتراضات الإحصائية (Assumptions)
معظم الاختبارات الإحصائية البارامترية (مثل T-test و ANOVA) تتطلب استيفاء افتراضات معينة (مثل التوزيع الطبيعي للبيانات، وتجانس التباين).
•التحدي: إذا لم يتم استيفاء هذه الافتراضات، فإن نتائج الاختبار قد تكون غير موثوقة.
•الحل:
•إجراء اختبارات الافتراضات (مثل اختبار شابيرو-ويلك للتوزيع الطبيعي).
•إذا لم يتم استيفاء الافتراضات، يجب اللجوء إلى الاختبارات الإحصائية اللابارامترية (Non-parametric tests) كبديل (مثل اختبار مان-ويتني بدلاً من T-test).
وللمقارنة بين النوعين راجع مقال الفرق بين الاختبارات المعلمية واللامعلمية.
4. تفسير النتائج السلبية (Non-Significant Results)
قد يجد الباحث أن جميع نتائجه “غير دالة إحصائيًا”. هذا لا يعني فشل البحث، بل يعني أن الفرضية الصفرية لم تُرفض.
•التفسير الصحيح: يجب مناقشة هذه النتائج بشجاعة، وتقديم تفسيرات منطقية لعدم وجود فرق أو علاقة. قد يكون السبب في طبيعة العينة، أو دقة الأداة، أو أن الإطار النظري بحاجة إلى مراجعة.
•القيمة البحثية: النتائج السلبية لها قيمة علمية كبيرة، فهي تمنع الباحثين الآخرين من تكرار نفس المسار وتوجههم نحو مسارات بحثية جديدة.
كتابة فصل النتائج ومناقشتها
1. هيكلة فصل النتائج
يجب أن يكون فصل النتائج منظمًا ومنطقيًا، وعادة ما يتبع الترتيب التالي:
1.البيانات الوصفية للعينة: وصف الخصائص الديموغرافية والاجتماعية للعينة (الجنس، العمر، المؤهل).
2.نتائج الإحصاء الوصفي للمتغيرات: عرض المتوسطات والانحرافات المعيارية للمتغيرات الرئيسية.
3.عرض نتائج اختبار الفرضيات: عرض نتائج كل فرضية على حدة، بدءًا من الفرضية الصفرية، ثم قيمة الاختبار، درجات الحرية، وقيمة الدلالة (P-value)، وأخيرًا القرار الإحصائي.
2. فن مناقشة النتائج
المناقشة هي قلب البحث، وهي المرحلة التي يظهر فيها الباحث كـمفكر ناقد.
•الربط بالدراسات السابقة: يجب مقارنة كل نتيجة رئيسية بالدراسات السابقة.
•الاتفاق: إذا اتفقت النتيجة، يجب تعزيزها بتفسير منطقي.
•الاختلاف: إذا اختلفت النتيجة، يجب تقديم تفسير مقنع ومحاولة فهم سبب هذا الاختلاف (السياق، المنهجية، العينة).
•التفسير النظري: يجب أن تكون المناقشة متجذرة في النظريات والمفاهيم التي اعتمد عليها البحث.
•الآثار العملية: يجب أن يوضح الباحث كيف يمكن تطبيق هذه النتائج في الواقع العملي (في المؤسسات التعليمية، أو الشركات، أو السياسات العامة).
3. استخدام الجداول والأشكال البيانية بفعالية
•الجداول: يجب أن تكون بسيطة، واضحة، وذاتية التفسير. لا تكرر في النص كل ما هو موجود في الجدول، بل ركز على النقاط الرئيسية.
•الأشكال البيانية (Graphs): استخدمها لتوضيح العلاقات المعقدة أو الفروق الواضحة. يجب أن تكون الأشكال جذابة ومهنية.
كيفية تفسير مستوى الدلالة في نتائج التحليل الإحصائي؟
مستوى الدلالة الإحصائية يساعد الباحث على تحديد ما إذا كانت النتيجة التي ظهرت في التحليل يمكن اعتبارها ذات دلالة إحصائية أم لا. ويُستخدم غالبًا مستوى دلالة 0.05 كمرجع شائع؛ فإذا كانت قيمة الاحتمال p-value أقل من 0.05 فهذا يشير عادةً إلى وجود نتيجة ذات دلالة إحصائية، أما إذا كانت أكبر من 0.05 فلا توجد دلالة إحصائية كافية وفق هذا المستوى. لكن لا ينبغي تفسير النتيجة اعتمادًا على قيمة p وحدها؛ بل يجب أيضًا النظر إلى حجم الأثر، وطبيعة الاختبار الإحصائي، وحجم العينة، وسياق البحث.
مثال مبسط على تفسير النتيجة
إذا أظهر اختبار إحصائي قيمة p = 0.03 عند مستوى دلالة 0.05، فإن النتيجة تُعد ذات دلالة إحصائية لأن 0.03 أقل من 0.05. أما إذا كانت p = 0.08، فلا تُعد النتيجة ذات دلالة إحصائية عند نفس المستوى.
أسئلة شائعة حول تفسير نتائج التحليل الإحصائي
ما المقصود بتفسير النتائج الإحصائية؟
تفسير النتائج الإحصائية هو تحويل الأرقام والقيم الناتجة عن الاختبارات الإحصائية إلى معنى واضح يساعد الباحث على الإجابة عن أسئلة الدراسة واختبار الفرضيات والوصول إلى استنتاجات منطقية.
متى تكون النتيجة ذات دلالة إحصائية؟
تُعد النتيجة ذات دلالة إحصائية عادةً عندما تكون قيمة p-value أقل من مستوى الدلالة المحدد مسبقًا، مثل 0.05، مع ضرورة مراعاة نوع الاختبار وحجم الأثر وسياق الدراسة.
ما الفرق بين التحليل الإحصائي وتفسير النتائج؟
التحليل الإحصائي هو تطبيق الاختبارات والأساليب الإحصائية على البيانات، أما تفسير النتائج فهو شرح معنى القيم والاختبارات الناتجة وربطها بفرضيات الدراسة وأهداف البحث.
ما معنى أن قيمة p أقل من 0.05؟
معناه أنه لو كانت الفرضية الصفرية صحيحة (لا يوجد فرق أو علاقة)، فإن احتمال الحصول على نتيجة مثل التي ظهرت في بياناتك أقل من 5%، لذلك نرفض الفرضية الصفرية ونقول إن النتيجة دالة إحصائيًا. ولا تعني أن احتمال صحة الفرضية البديلة 95%، ولا تدل وحدها على أن الأثر كبير؛ لذلك ننظر أيضًا إلى حجم الأثر.
ماذا تعني Sig. = 0.000 في SPSS؟
لا تعني أن الاحتمال صفر، بل أنه أصغر من 0.0005 فظهر بعد التقريب بثلاث خانات عشرية صفرًا. اكتبها في الرسالة p < 0.001.
هل النتيجة غير الدالة تعني أن البحث فشل؟
لا. النتيجة غير الدالة نتيجة علمية مثل غيرها، وتُكتب بالطريقة نفسها، ثم تُناقش أسبابها المحتملة مثل حجم العينة أو طبيعة المجتمع أو الأداة المستخدمة.
الخلاصة
تفسير النتائج يسير بترتيب ثابت: ابدأ بالإحصاء الوصفي، ثم تحقق من الافتراضات، ثم اقرأ قيمة الاختبار ومستوى الدلالة، ثم حدد اتجاه الفرق أو العلاقة وحجم الأثر، وأخيرًا اربط النتيجة بالإطار النظري والدراسات السابقة. وتذكّر أن p أقل من 0.05 تخبرك بأن النتيجة دالة، لكنها لا تخبرك وحدها بأهميتها العملية.
تحتاج مساعدة في تفسير نتائج رسالتك؟
في خدمة التحليل الإحصائي المتكاملة يُنفّذ المحلل التحليل ويكتب تفسير النتائج بلغة رسالتك، مع جلسة نقاش للنتائج عند الطلب. تعرّف على خدمة التحليل الإحصائي المتكاملة، والاستشارة مجانية والسعر يتحدد بعد مراجعة البيانات.

لا يوجد تعليق